
Wstęp
Integrujesz się z zewnętrznym API. Na devie wszystko śmiga, testy przechodzą, na stagingu też jest okej, a potem przychodzi pierwszy poniedziałek na produkcji i nagle w logach pojawia się 503 Service Unavailable. Raz, drugi, po chwili kolejny. A po kilku minutach zaczyna się zawieszać cała aplikacja, bo wątki czekają na odpowiedź, która nie przychodzi. I tutaj już nie chodzi o jeden błąd w logach, tylko o klientów, którzy nie mogą złożyć zamówienia.
Tak to bywa, że nasz kod może być napisany bardzo dobrze, a i tak wszystko położy coś, na co nie mamy żadnego wpływu. Dobrym przykładem jest awaria AWS z października 2025 roku. W regionie us-east-1 automatyzacja DNS dla DynamoDB zostawiła pusty rekord dla jej regionalnego endpointu, więc nagle nie dało się do niej połączyć. Najpierw błędy zaczęły zgłaszać usługi, które z niej korzystały, potem posypało się uruchamianie instancji EC2 i load balancery, a całość ciągnęła się kilkanaście godzin. Odczuły to między innymi Slack i Snapchat. Klasyczny efekt domina: jedna usługa przestaje odpowiadać, a za nią pada kolejna i kolejna (jeśli chcesz poczytać szczegóły, AWS opublikował całe podsumowanie awarii).
Oczywiście Twoja aplikacja raczej nie obsługuje połowy internetu :). Natomiast mechanizm jest dokładnie ten sam, tylko w mniejszej skali. Dlatego w tym wpisie chciałbym Ci pokazać, jak przygotować aplikację w Spring Boot 4 na sytuację, w której zewnętrzne API zawodzi. Przez cały wpis będziemy pracować na jednym przykładzie: sklep internetowy, który przy składaniu zamówienia pyta API firmy kurierskiej o cenę dostawy. To API będzie nam się psuło na różne sposoby, a my za każdym razem dobierzemy do tego inny mechanizm.
Zaczniemy od tego, co Spring Boot 4 ma od ręki, bez żadnych bibliotek: @Retryable i @ConcurrencyLimit. A potem przejdziemy do Resilience4j i takie pojęcia jak circuit breaker, time limiter, rate limiter i bulkhead.
Co to jest resilience?
Resilience to po prostu odporność aplikacji na awarie. Coś psuje się w jednym miejscu, najczęściej w usłudze, nad którą nie mamy kontroli, a reszta systemu dalej działa. Przy chwilowym błędzie aplikacja ponawia próbę. Gdy usługa leży, przestaje ją dobijać. A klient zamiast stack trace’a dostaje coś, z czym da się dalej pracować.
Najlepiej to widać na przykładzie bezpiecznika w domu. Jak w jednym gniazdku coś zrobi zwarcie, to bezpiecznik się wyłącza i odcina prąd w tym obwodzie. Dzięki temu nie pali się cała instalacja, a reszta mieszkania działa normalnie. Po naprawie włączasz bezpiecznik z powrotem. Circuit breaker, o którym będzie dalej, działa praktycznie identycznie i nawet nazwę wziął właśnie od tego.
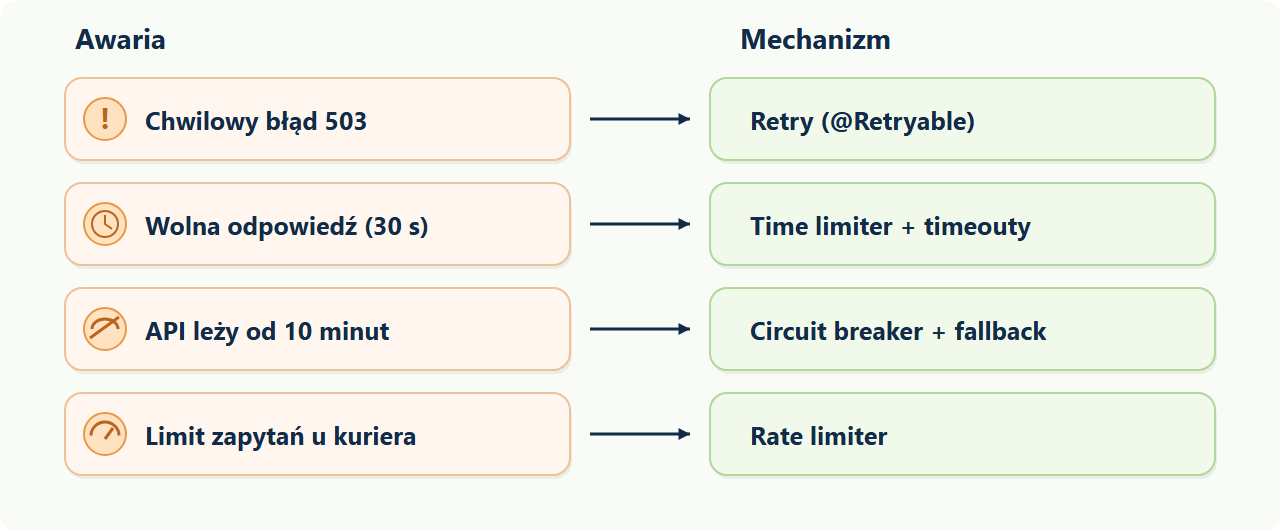
Wróćmy do naszego sklepu. Mamy w nim serwis ShippingService, który przy każdym koszyku woła API kuriera o wycenę dostawy. Z reguły jest tak, że takie API psuje się na kilka powtarzalnych sposobów:
- Chwilowy błąd – API zwraca
503, bo akurat ktoś wdraża nową wersję albo serwer jest przeciążony. Sekundę później wszystko wraca do normy. - Wolna odpowiedź – API odpowiada, ale po 20-30 sekundach. Niby działa, ale do klienta idzie długo odpowiedź.
- API leży całkowicie – tu nie ma co ponawiać, bo przez kilka, czasem kilkanaście minut i tak nic nie przejdzie.
- Limit zapytań – kurier pozwala na określoną liczbę zapytań na sekundę, a my w Black Friday (czy nawet Black Week teraz) wysyłamy dużo więcej.
Każda z tych sytuacji wymaga czegoś innego i moim zdaniem to jest najważniejsze w całym temacie. Jednej adnotacji na wszystko nie ma. Co gorsza, źle dobrany mechanizm potrafi tylko dołożyć problemów.
Retry w Spring Boot 4
Zacznijmy od najprostszego przypadku, czyli chwilowego błędu. API zwróciło 503, a my wiemy, że za sekundę najpewniej odpowie poprawnie. Pierwsze, co przychodzi do głowy? Spróbować jeszcze raz.
Bez dodatkowych zależności: @EnableResilientMethods
Jeszcze niedawno do retry w Springu potrzebna była osobna biblioteka Spring Retry. W Spring Boot 4 nie trzeba już niczego dodawać, bo podstawowe mechanizmy resilience trafiły bezpośrednio do Spring Framework 7, na którym Boot 4 jest zbudowany. Wystarczy je włączyć jedną adnotacją na klasie konfiguracyjnej:
@Configuration
@EnableResilientMethods
class ResilienceConfig {
}
@EnableResilientMethods włącza obsługę dwóch adnotacji: @Retryable i @ConcurrencyLimit. Obie działają przez proxy, tak samo jak @Transactional czy @Async, co będzie miało znaczenie przy pułapkach.
Zanim przejdziemy do kodu, rozdzielmy jeszcze nasz przykład na dwie warstwy. CourierApi to cienka klasa, która tylko wysyła zapytanie HTTP przez RestClient. ShippingService to serwis, który z niej korzysta i na którym będziemy zakładać wszystkie mechanizmy resilience. Taki podział przyda się zarówno przy pułapkach, jak i przy testach.
public record ShippingQuoteRequest(String postalCode, BigDecimal weightKg) {
}

public record ShippingQuote(BigDecimal price, String currency, int deliveryDays, boolean estimated) {
}
@Component
public class CourierApi {

    private final RestClient restClient;

    public CourierApi(RestClient.Builder builder) {
        // Timeouty ustawiamy zawsze, niezależnie od retry i circuit breakera
        var httpClient = HttpClient.newBuilder()
                .connectTimeout(Duration.ofSeconds(2))
                .build();
        var requestFactory = new JdkClientHttpRequestFactory(httpClient);
        requestFactory.setReadTimeout(Duration.ofSeconds(3));

        this.restClient = builder
                .baseUrl("https://api.courier.example")
                .requestFactory(requestFactory)
                .build();
    }

    public ShippingQuote fetchQuote(ShippingQuoteRequest request) {
        return restClient.post()
                .uri("/v1/quotes")
                .body(request)
                .retrieve()
                .body(ShippingQuote.class);
    }
}
Zwróć uwagę na timeouty. Domyślnie klient HTTP potrafi czekać na odpowiedź bardzo długo, a żaden z mechanizmów, które dzisiaj omawiamy, nie zastąpi rozsądnie ustawionego readTimeout. To jest pierwsza rzecz, którą ustawiam przy każdej integracji.
@Retryable w praktyce
Teraz ShippingService i nasze pierwsze retry:
@Service
public class ShippingService {

    private final CourierApi courierApi;

    public ShippingService(CourierApi courierApi) {
        this.courierApi = courierApi;
    }

    @Retryable(
            includes = {HttpServerErrorException.class, ResourceAccessException.class},
            maxRetries = 3,
            delay = 500,
            multiplier = 2,
            jitter = 100,
            maxDelay = 4000)
    public ShippingQuote getQuote(ShippingQuoteRequest request) {
        return courierApi.fetchQuote(request);
    }
}
Przejdźmy po kolei przez parametry:
includes– przy jakich wyjątkach ponawiamy.HttpServerErrorExceptionto błędy5xx, aResourceAccessExceptionto problemy z połączeniem, np. timeout. Celowo nie ma tutajHttpClientErrorException, czyli błędów4xx. Jak wyślemy zły kod pocztowy i dostaniemy400, to kolejne próby nic nie zmienią.maxRetries = 3– maksymalnie 3 ponowienia po pierwszej nieudanej próbie, czyli łącznie do 4 wywołań.delay = 500– pierwsze ponowienie po 500 ms.multiplier = 2– każde kolejne opóźnienie jest dwa razy dłuższe: 500 ms, 1000 ms, 2000 ms.jitter = 100– losowe przesunięcie opóźnienia o maksymalnie 100 ms w górę lub w dół.maxDelay = 4000– górny limit pojedynczego opóźnienia.
Jeżeli nie podasz żadnych parametrów, to domyślnie @Retryable ponawia przy każdym wyjątku, maksymalnie 3 razy, co 1 sekundę. Jako start może być, natomiast osobiście zawsze zawężałbym chociaż includes.
Jedna różnica potrafi namieszać, jeśli korzystałeś wcześniej ze Spring Retry albo zaraz będziesz konfigurować Resilience4j. W starym Spring Retry i w Resilience4j maxAttempts = 3 oznacza 3 wywołania łącznie z pierwszym. W nowym @Retryable ze Spring Framework 7 maxRetries = 3 oznacza 3 ponowienia po pierwszym, czyli 4 wywołania. Niby drobiazg, ale przy przenoszeniu konfiguracji prędzej czy później ktoś się o to jedno wywołanie pomyli.
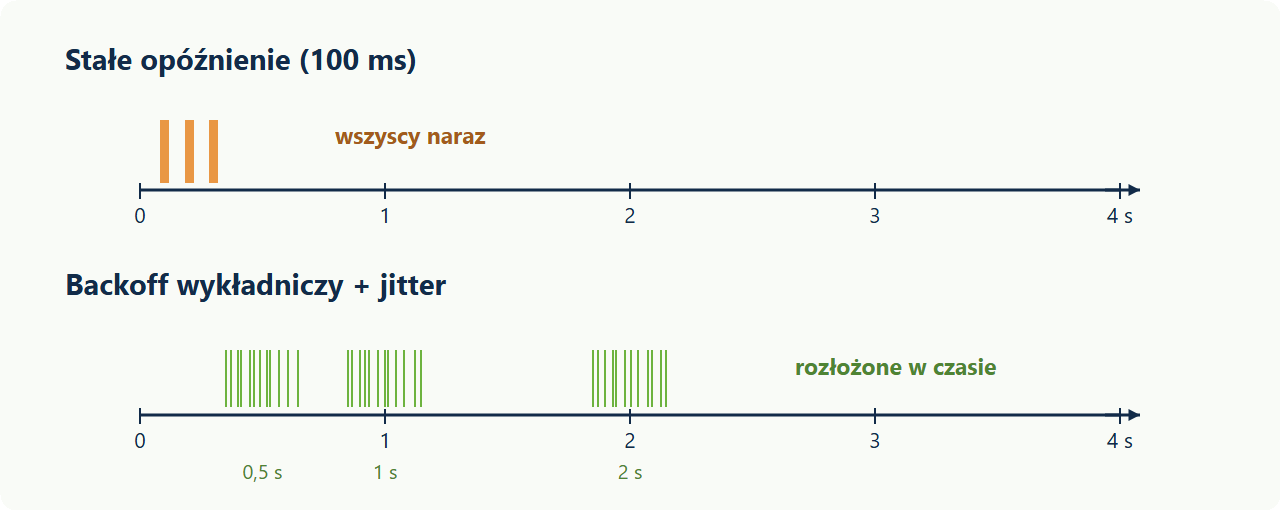
Backoff i jitter, czyli dlaczego nie ponawiać co 100 ms
Po co komu rosnące opóźnienie, a do tego jeszcze losowe przesunięcia? Przecież najprościej byłoby ponawiać od razu albo co 100 ms.
Załóżmy, że API kuriera jest przeciążone i dlatego zwraca 503. Nasz sklep ma w tej chwili 200 aktywnych koszyków. Każdy z nich dostaje błąd i każdy od razu ponawia, i to 3 razy. Z 200 zapytań robi się nagle 800, i to wysłanych do serwera, który już wcześniej sobie nie radził. Taka sytuacja ma nawet swoją nazwę: burza retry (retry storm). Retry, które miało pomóc, dobija usługę, a ona zamiast wstać po kilku sekundach, leży kilka minut.
Backoff wykładniczy (rosnące opóźnienie) daje usłudze czas na powrót. Natomiast sam backoff nie wystarczy, bo jeśli wszystkie 200 koszyków dostało błąd w tej samej chwili, to z tym samym opóźnieniem wszystkie ponowią też w tej samej chwili. I tutaj przydaje się jitter, który losowo rozrzuca te próby w czasie, więc serwer dostaje zapytania równomiernie, a nie falami.
Pułapki, na które trzeba uważać
Retry wygląda niewinnie, jedna adnotacja i gotowe. Natomiast to właśnie przy retry najłatwiej o błędy, które wychodzą dopiero na produkcji.
Retry przy tworzeniu zasobów i duplikaty. Wycena dostawy to bezpieczna operacja: możesz zapytać 5 razy i nic się nie stanie. Ale załóżmy, że po złożeniu zamówienia tworzymy też przesyłkę u kuriera przez POST /v1/shipments. Wysyłamy zapytanie, kurier tworzy przesyłkę, a odpowiedź do nas nie dochodzi, bo po drodze kończy się timeout. Dla nas to błąd, więc retry wysyła zapytanie jeszcze raz. I mamy dwie przesyłki do jednego zamówienia.
Dlatego retry zakładamy tylko na operacjach idempotentnych, czyli takich, które wykonane kilka razy dają ten sam efekt co wykonane raz. Jeśli operacja z natury taka nie jest, to można ją taką zrobić kluczem idempotencji. Sporo API (np. płatności) obsługuje nagłówek Idempotency-Key: serwer zapamiętuje klucz i przy powtórzonym zapytaniu z tym samym kluczem nie tworzy nowego zasobu, tylko zwraca poprzedni wynik. Ważne, żeby klucz był taki sam przy każdej próbie, więc najprościej oprzeć go na identyfikatorze zamówienia:
@Retryable(includes = {HttpServerErrorException.class, ResourceAccessException.class})
public Shipment createShipment(String orderId, ShipmentRequest request) {
    return restClient.post()
            .uri("/v1/shipments")
            // Ten sam klucz przy każdej próbie, kurier nie utworzy drugiej przesyłki
            .header("Idempotency-Key", "order-" + orderId)
            .body(request)
            .retrieve()
            .body(Shipment.class);
}
Gdybyśmy w środku metody wygenerowali UUID.randomUUID(), to każda próba miałaby inny klucz i cały mechanizm nic by nie dał. No i API kuriera musi ten nagłówek w ogóle obsługiwać, więc najpierw zajrzyj do jego dokumentacji.
@Retryable razem z @Transactional. Jeśli na jednej metodzie masz obie adnotacje, to retry zawsze opakowuje transakcję, niezależnie od ustawionej kolejności. Każda próba dostaje więc własną transakcję: poprzednia się wycofuje, kolejna startuje od zera. I zwykle o to właśnie chodzi. Gorzej, jeśli w takiej metodzie siedzi wywołanie HTTP, bo wtedy każda próba trzyma połączenie do bazy przez cały czas czekania na API. Dodaj do tego backoff między próbami i połączenie jest zajęte przez kilka sekund. Więcej o tym, czemu wywołania zewnętrzne w transakcji to zły pomysł, pisałem w szybkim strzale Kiedy nie używać @Transactional w Springu? (a jeśli chcesz najpierw przypomnieć sobie podstawy, to zajrzyj do wpisu o tym, jak działa @Transactional).
Wywołanie metody z tej samej klasy. @Retryable działa przez proxy, więc tak samo jak przy @Transactional, wywołanie this.getQuote(...) z innej metody tej samej klasy omija proxy i retry po prostu się nie wykona. Nie będzie żadnego błędu ani ostrzeżenia, adnotacja zostanie zignorowana. Dlatego w naszym przykładzie ShippingService woła osobny bean CourierApi, a z ShippingService korzystają inne klasy, np. kontroler koszyka.
RetryTemplate, gdy wolisz bez adnotacji
Czasami adnotacja nie pasuje, np. chcesz ponowić tylko fragment metody albo ustawiać parametry w kodzie. Wtedy możesz użyć RetryTemplate, który też jest częścią Spring Framework 7:
var retryPolicy = RetryPolicy.builder()
        .includes(HttpServerErrorException.class, ResourceAccessException.class)
        .maxRetries(3)
        .delay(Duration.ofMillis(500))
        .multiplier(2)
        .jitter(Duration.ofMillis(100))
        .maxDelay(Duration.ofSeconds(4))
        .build();

var retryTemplate = new RetryTemplate(retryPolicy);

ShippingQuote quote = retryTemplate.invoke(() -> courierApi.fetchQuote(request));
Parametry znasz już z adnotacji. Gdy próby się skończą, invoke rzuca ostatni oryginalny wyjątek, czyli w naszym przypadku HttpServerErrorException. Jeśli chcesz wiedzieć, co poszło nie tak w każdej próbie, użyj execute. Ta rzuca RetryException z wyjątkami ze wszystkich prób.
@ConcurrencyLimit – prosty limit równoległych wywołań
Druga adnotacja, którą włącza @EnableResilientMethods, to @ConcurrencyLimit. Pilnuje, żeby daną metodę wykonywało jednocześnie najwyżej tyle wątków, ile ustawisz.
Po co to komu? Załóżmy, że API kuriera słabo znosi dużo równoległych połączeń i przy 50 jednoczesnych zapytaniach zaczyna zwracać błędy. Możemy wtedy ograniczyć się do np. 10 naraz:
@ConcurrencyLimit(10)
@Retryable(includes = {HttpServerErrorException.class, ResourceAccessException.class})
public ShippingQuote getQuote(ShippingQuoteRequest request) {
    return courierApi.fetchQuote(request);
}
Jedenasty wątek, który wejdzie do tej metody, poczeka, aż któryś z pierwszych dziesięciu skończy. Trochę jak pula połączeń do bazy: miejsc jest tyle, ile jest, reszta czeka w kolejce. Ustawienie @ConcurrencyLimit(1) sprawia, że metoda jest wykonywana przez jeden wątek naraz.
Szczególnie przydaje się to przy wirtualnych wątkach (w Spring Boot 4 włączasz je przez spring.threads.virtual.enabled=true). Przy klasycznej puli wątków Tomcata liczba równoległych zapytań i tak była ograniczona wielkością puli. Z wirtualnymi wątkami takiego naturalnego limitu nie ma i aplikacja potrafi bez problemu wysłać do kuriera kilkaset zapytań jednocześnie. Dla nas super, dla kuriera już niekoniecznie :). @ConcurrencyLimit przywraca ten limit w miejscu, w którym go potrzebujesz.
Jedna rzecz, o której warto wiedzieć: @ConcurrencyLimit blokuje i czeka, aż zwolni się miejsce. Nie ma tutaj maksymalnego czasu oczekiwania ani możliwości odrzucenia wywołania z fallbackiem. Jeśli tego potrzebujesz, to za chwilę zobaczysz bulkhead z Resilience4j.
Kiedy wbudowane mechanizmy przestają wystarczać
Mamy retry z backoffem, mamy limit współbieżności. Do obsługi chwilowych błędów to naprawdę wystarczy i w wielu projektach na tym można skończyć. Natomiast wróćmy do trzeciego scenariusza z początku wpisu, czyli API, które leży od 10 minut.
Co robi wtedy nasz @Retryable? Każde zapytanie o wycenę próbuje 4 razy, z opóźnieniami 0,5 s, 1 s i 2 s. Każdy klient czeka więc kilka sekund (do tego dochodzą timeouty), żeby i tak dostać błąd. A API kuriera, które próbuje wstać, dostaje od nas cztery razy więcej zapytań niż normalnie. Retry nie wie, że usługa leży od dłuższego czasu. Ono przy każdym wywołaniu zaczyna od zera.
Do tego potrzebny jest mechanizm, który pamięta, co działo się z poprzednimi wywołaniami, i potrafi powiedzieć: dobra, przez najbliższe 30 sekund w ogóle nie wołamy kuriera, tylko od razu zwracamy fallback. To jest właśnie circuit breaker. Tak samo nie mamy jeszcze obsługi API, które odpowiada po 30 sekundach, limitu zapytań na sekundę ani fallbacku. W Spring Boot 4 nie ma tego w standardzie, więc sięgamy po Resilience4j.
Resilience4j w Spring Boot 4 – konfiguracja
Resilience4j to lekka biblioteka, która daje zestaw mechanizmów resilience: circuit breaker, retry, time limiter, rate limiter i bulkhead. Od wersji 2.4.0 ma osobny moduł dla Spring Boot 4, więc konfiguracja sprowadza się do dodania zależności:
dependencies {
    implementation 'io.github.resilience4j:resilience4j-spring-boot4:2.4.0'
    implementation 'org.springframework.boot:spring-boot-starter-aspectj'
    implementation 'org.springframework.boot:spring-boot-starter-actuator'
}
Adnotacje z Resilience4j działają przez aspekty, więc potrzebny jest spring-boot-starter-aspectj. Jeśli przenosisz projekt ze Spring Boot 3, to pamiętaj, że ten starter wcześniej nazywał się spring-boot-starter-aop, a w Boot 4 zmienił nazwę. Actuator nie jest wymagany do działania samych mechanizmów, ale bez niego nie podejrzysz stanu circuit breakera, a to bardzo się przydaje.
Konfigurację Resilience4j trzymamy w application.yml. Każdy mechanizm ma swoje instancje z nazwami, a w kodzie odwołujemy się do nich po nazwie. W naszym przykładzie wszystkie instancje będą nazywać się shippingApi.
Circuit breaker w Spring Boot 4
Stany CLOSED, OPEN i HALF_OPEN
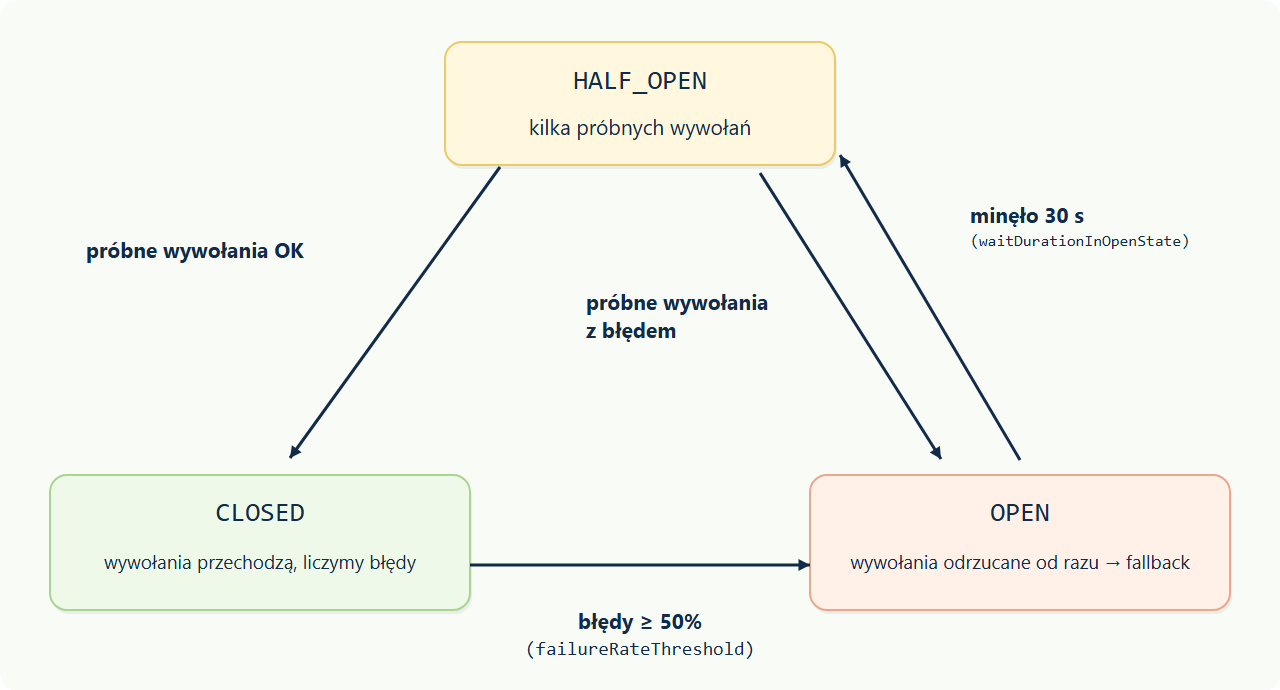
Circuit breaker ma trzy stany i całe jego działanie sprowadza się do przechodzenia między nimi:
- CLOSED – stan normalny. Wywołania przechodzą do API, a circuit breaker liczy, ile z nich kończy się błędem albo trwa za długo.
- OPEN – gdy odsetek błędów przekroczy próg, circuit breaker się otwiera. Przez ustalony czas wywołania w ogóle nie idą do API, zamiast tego od razu leci wyjątek
CallNotPermittedException(albo fallback, jeśli go zdefiniujemy). - HALF_OPEN – po tym czasie circuit breaker puszcza kilka próbnych wywołań, żeby sprawdzić, czy API już wstało. Udało się – wraca do CLOSED. Nie udało się – znowu OPEN.
Na początku może to zmylić: „zamknięty” oznacza tu, że wszystko działa. Bierze się to z analogii z bezpiecznikiem: zamknięty obwód przewodzi prąd, otwarty go przerywa.
Konfiguracja w application.yml
Teraz konfiguracja dla naszego API kuriera:
resilience4j:
  circuitbreaker:
    instances:
      shippingApi:
        slidingWindowType: COUNT_BASED
        slidingWindowSize: 20
        minimumNumberOfCalls: 10
        failureRateThreshold: 50
        slowCallDurationThreshold: 2s
        slowCallRateThreshold: 80
        waitDurationInOpenState: 30s
        permittedNumberOfCallsInHalfOpenState: 3
        automaticTransitionFromOpenToHalfOpenEnabled: true
        registerHealthIndicator: true
        recordExceptions:
          - org.springframework.web.client.HttpServerErrorException
          - org.springframework.web.client.ResourceAccessException
Co tu się dzieje:
slidingWindowType: COUNT_BASEDislidingWindowSize: 20– circuit breaker patrzy na ostatnie 20 wywołań. Można też ustawić okno czasowe (TIME_BASED), wtedy rozmiar oznacza liczbę sekund.minimumNumberOfCalls: 10– dopóki nie będzie co najmniej 10 wywołań, circuit breaker nie liczy odsetka błędów. Bez tego jeden błąd na starcie aplikacji oznaczałby 100% błędów i od razu otwarcie.failureRateThreshold: 50– otwieramy, gdy co najmniej połowa wywołań w oknie zakończyła się błędem.slowCallDurationThreshold: 2sislowCallRateThreshold: 80– wywołanie dłuższe niż 2 sekundy liczy się jako wolne, a gdy wolnych jest co najmniej 80%, circuit breaker też się otwiera. Przydaje się, gdy API niby odpowiada, ale ślimaczy się z każdą odpowiedzią.waitDurationInOpenState: 30s– tyle czasu circuit breaker jest otwarty, zanim spróbuje ponownie.permittedNumberOfCallsInHalfOpenState: 3– liczba próbnych wywołań w stanie HALF_OPEN.automaticTransitionFromOpenToHalfOpenEnabled: true– przejście do HALF_OPEN następuje automatycznie po 30 sekundach, a nie dopiero przy pierwszym wywołaniu po tym czasie.recordExceptions– tylko te wyjątki liczymy jako błąd. Tak samo jak przy retry,400od kuriera nie oznacza, że jego API leży, więc nie powinien otwierać circuit breakera.
Domyślne wartości w Resilience4j są dość „ostrożne”: okno 100 wywołań, minimum 100 wywołań i 60 sekund w stanie OPEN. Przy mniejszym ruchu circuit breaker z domyślną konfiguracją może się nie otworzyć nigdy, dlatego dopasuj je do ruchu, jaki faktycznie masz.
Fallback, czyli co zwrócić klientowi, kiedy kurier nie odpowiada
Otwarty circuit breaker to dopiero połowa roboty. Trzeba jeszcze zdecydować, co w tym czasie dostanie klient, i do tego służy fallback, czyli metoda zapasowa:
@Service
public class ShippingService {

    private static final Logger log = LoggerFactory.getLogger(ShippingService.class);

    private final CourierApi courierApi;

    public ShippingService(CourierApi courierApi) {
        this.courierApi = courierApi;
    }

    @CircuitBreaker(name = "shippingApi", fallbackMethod = "fallbackQuote")
    public ShippingQuote getQuote(ShippingQuoteRequest request) {
        return courierApi.fetchQuote(request);
    }

    // Circuit breaker otwarty - API kuriera w ogóle nie zostało wywołane
    private ShippingQuote fallbackQuote(ShippingQuoteRequest request, CallNotPermittedException ex) {
        log.warn("Circuit breaker open, returning flat shipping rate for {}", request.postalCode());
        return flatRate();
    }

    // Każdy inny błąd wywołania
    private ShippingQuote fallbackQuote(ShippingQuoteRequest request, Exception ex) {
        log.warn("Courier API call failed, returning flat shipping rate", ex);
        return flatRate();
    }

    private ShippingQuote flatRate() {
        return new ShippingQuote(new BigDecimal("19.99"), "PLN", 3, true);
    }
}
Metoda fallback musi być w tej samej klasie i mieć taką samą sygnaturę jak oryginalna metoda, z jednym dodatkowym parametrem na wyjątek na końcu. Wersji może być kilka, każda dla innego wyjątku. Resilience4j wybierze najlepiej dopasowaną, tak jak przy kilku blokach catch.
No dobra, ale co tak naprawdę zwrócić? To już jest decyzja biznesowa, a nie techniczna. W naszym przykładzie zwracamy stałą cenę ryczałtową z flagą estimated = true, żeby frontend mógł pokazać komunikat w stylu „cena dostawy może się nieznacznie różnić”. Inne opcje to ostatnia wycena z cache albo komunikat, że wycena jest chwilowo niedostępna. Klient raczej woli zamówić z szacunkową ceną dostawy niż oglądać stronę z błędem. Przy płatnościach tak łatwo już nie ma i fallback w stylu „udajmy, że się udało” to proszenie się o kłopoty.
Jeżeli zamiast wartości domyślnej wolisz zwrócić klientowi konkretny błąd, to fallback może też rzucić własny wyjątek, który obsłużysz globalnie. Jak to zrobić, pokazywałem we wpisie o tym, jak napisać własny wyjątek w Springu i obsłużyć go globalnie.
Jak sprawdzić, że circuit breaker naprawdę się otwiera
Konfiguracja circuit breakera to jedna z tych rzeczy, które łatwo napisać i trudno sprawdzić, bo w normalnych warunkach API działa i circuit breaker przez cały czas jest w stanie CLOSED. Dlatego dobrze mieć test, który tę awarię zasymuluje. Tutaj przydaje się podział na CourierApi i ShippingService, bo CourierApi możemy po prostu podmienić na mocka:
@SpringBootTest
class ShippingServiceCircuitBreakerTest {

    @Autowired
    ShippingService shippingService;

    @Autowired
    CircuitBreakerRegistry circuitBreakerRegistry;

    @MockitoBean
    CourierApi courierApi;

    @Test
    void shouldOpenCircuitBreakerAfterRepeatedFailures() {
        var request = new ShippingQuoteRequest("00-001", new BigDecimal("2.5"));
        when(courierApi.fetchQuote(request)).thenThrow(
                HttpServerErrorException.create(HttpStatus.SERVICE_UNAVAILABLE,
                        "Service Unavailable", new HttpHeaders(), null, null));

        // 10 nieudanych wywołań = minimumNumberOfCalls, 100% błędów
        for (int i = 0; i < 10; i++) {
            shippingService.getQuote(request);
        }

        var circuitBreaker = circuitBreakerRegistry.circuitBreaker("shippingApi");
        assertThat(circuitBreaker.getState()).isEqualTo(CircuitBreaker.State.OPEN);

        // Kolejne wywołanie dostaje fallback, a API kuriera nie jest już wołane
        var quote = shippingService.getQuote(request);
        assertThat(quote.estimated()).isTrue();
        verify(courierApi, times(10)).fetchQuote(request);
    }
}
Sprawdzamy tu dwie rzeczy: czy po 10 błędach circuit breaker faktycznie jest w stanie OPEN i czy jedenaste wywołanie nie trafia już do API kuriera (mock został wywołany dokładnie 10 razy), a klient dostaje fallback. W tym przykładzie na metodzie jest tylko @CircuitBreaker. Gdybyś dołożył też retry, to liczba wywołań mocka się zmieni, więc test trzeba dopasować.
Na działającej aplikacji stan circuit breakera podejrzysz przez Actuator. Wystarczy wystawić odpowiednie endpointy:
management:
  endpoints:
    web:
      exposure:
        include: health,circuitbreakers,circuitbreakerevents
  health:
    circuitbreakers:
      enabled: true
Pod /actuator/circuitbreakers zobaczysz listę circuit breakerów z ich aktualnym stanem, a pod /actuator/circuitbreakerevents ostatnie zdarzenia, np. przejścia między stanami i odrzucone wywołania. Dzięki registerHealthIndicator: true stan trafia też do /actuator/health: CLOSED to UP, OPEN to DOWN, a HALF_OPEN to UNKNOWN. Tylko uważaj z tym ostatnim, jeśli Kubernetes używa /actuator/health jako probe. Otwarty circuit breaker do zewnętrznego API nie powinien sprawiać, że Kubernetes zacznie restartować Twoje pody, bo restart w niczym tu nie pomoże.
Time limiter – API, które odpowiada po 30 sekundach
Drugi scenariusz z początku wpisu to API, które odpowiada, ale bardzo wolno. Część tego problemu rozwiązaliśmy już na samym początku, ustawiając readTimeout w CourierApi. Przy wywołaniach synchronicznych przez RestClient uważam to za najlepsze rozwiązanie. Timeout na poziomie klienta HTTP jest prosty i wiadomo, czego się po nim spodziewać.
Resilience4j ma do tego osobny mechanizm, czyli TimeLimiter. Haczyk jest taki, że działa tylko z metodami asynchronicznymi, które zwracają CompletableFuture (albo typy reaktywne, jak Mono). Na zwykłej metodzie zwracającej ShippingQuote adnotacja @TimeLimiter nie zadziała. Dlatego przydaje się głównie wtedy, gdy i tak wołasz API asynchronicznie, np. pytasz kilku kurierów równolegle i chcesz pokazać klientowi tych, którzy zdążyli odpowiedzieć.
@TimeLimiter(name = "shippingApi", fallbackMethod = "fallbackQuoteAsync")
@CircuitBreaker(name = "shippingApi")
public CompletableFuture<ShippingQuote> getQuoteAsync(ShippingQuoteRequest request) {
    return CompletableFuture.supplyAsync(() -> courierApi.fetchQuote(request), executor);
}

private CompletableFuture<ShippingQuote> fallbackQuoteAsync(ShippingQuoteRequest request, Exception ex) {
    return CompletableFuture.completedFuture(flatRate());
}
executor to w tym przykładzie wstrzyknięty bean, np. Executors.newVirtualThreadPerTaskExecutor(). A konfiguracja w application.yml:
resilience4j:
  timelimiter:
    instances:
      shippingApi:
        timeoutDuration: 2s
        cancelRunningFuture: true
Po 2 sekundach TimeLimiter przerywa czekanie i zwraca fallback. Tylko że cancelRunningFuture: true anuluje CompletableFuture, ale samo zapytanie HTTP w tle może dalej trwać. Dlatego nawet z TimeLimiter nie rezygnowałbym z readTimeout w kliencie HTTP. Time limiter chroni klienta przed czekaniem, a timeout HTTP chroni zasoby aplikacji.
Rate limiter i bulkhead w skrócie
Zostały nam jeszcze dwa mechanizmy. Tu krócej niż przy circuit breakerze, bo w praktyce sięga się po nie rzadziej. Dobrze jednak wiedzieć, kiedy się przydają.
Rate limiter
Czwarty scenariusz: kurier w umowie ma limit 10 zapytań na sekundę, a powyżej odpowiada 429 Too Many Requests (a przy częstym przekraczaniu może nawet zablokować klucz API). Nie trzeba czekać, aż kurier nas przytnie. Limitu możemy pilnować sami:
resilience4j:
  ratelimiter:
    instances:
      shippingApi:
        limitForPeriod: 10
        limitRefreshPeriod: 1s
        timeoutDuration: 500ms
@RateLimiter(name = "shippingApi", fallbackMethod = "fallbackQuote")
@CircuitBreaker(name = "shippingApi", fallbackMethod = "fallbackQuote")
public ShippingQuote getQuote(ShippingQuoteRequest request) {
    return courierApi.fetchQuote(request);
}
W każdej sekundzie przechodzi maksymalnie 10 wywołań. Jedenaste czeka do 500 ms na kolejną pulę, a jeśli się nie doczeka, dostaje wyjątek RequestNotPermitted i trafia do fallbacku. Pamiętaj tylko, że taki limit działa w obrębie jednej instancji aplikacji. Jeśli masz 3 pody, to razem wyślą do 30 zapytań na sekundę, więc limit trzeba podzielić przez liczbę instancji albo użyć rozwiązania współdzielonego, np. opartego o Redis.
Bulkhead
Bulkhead to ten sam pomysł co @ConcurrencyLimit, czyli limit jednoczesnych wywołań. W aplikacji chodzi o to, żeby wolne API kuriera nie zajęło wszystkich wątków i nie zablokowało np. wyszukiwarki produktów.
resilience4j:
  bulkhead:
    instances:
      shippingApi:
        maxConcurrentCalls: 10
        maxWaitDuration: 100ms
Od @ConcurrencyLimit odróżnia go maxWaitDuration. Jeśli przez 100 ms nie zwolni się miejsce, wywołanie dostaje BulkheadFullException i możesz obsłużyć je fallbackiem. @ConcurrencyLimit po prostu czeka. Dlatego jeśli wystarczy Ci sam limit, to osobiście wybrałbym @ConcurrencyLimit i nie dokładał zależności. Jeśli potrzebujesz odrzucać nadmiarowe wywołania i zwracać fallback, to bulkhead.
Łączenie mechanizmów i ich kolejność
Rzadko kończy się na jednym mechanizmie. Retry z circuit breakerem to częsty duet, czasem dochodzi do tego rate limiter. Tylko w jakiej kolejności one się wtedy wykonują?
W Resilience4j domyślna kolejność aspektów wygląda tak:
Retry ( CircuitBreaker ( RateLimiter ( TimeLimiter ( Bulkhead ( Function ) ) ) ) )
Retry jest na samym zewnątrz, a bulkhead najbliżej wywoływanej metody. Każda próba retry przechodzi więc przez circuit breaker i każda jest przez niego liczona.
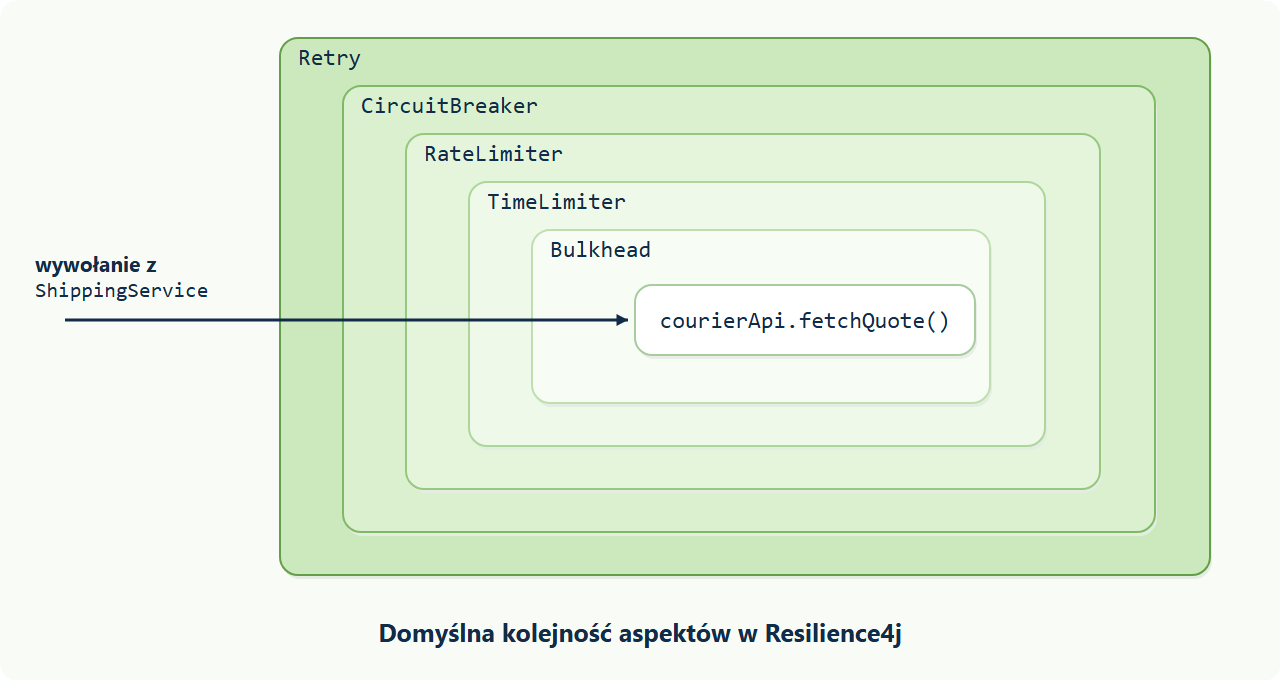
Co z tego wynika w praktyce? Załóżmy, że mamy retry z 3 próbami i circuit breaker. API leży, circuit breaker się otwiera i od tej pory każde wywołanie od razu dostaje CallNotPermittedException. Jeśli retry nie wie, że ma tego wyjątku nie ponawiać, to i tak spróbuje kilka razy, każdorazowo czekając na backoff, żeby i tak dostać ten sam wyjątek. Dlatego w konfiguracji retry w Resilience4j ten wyjątek wykluczamy:
resilience4j:
  retry:
    instances:
      shippingApi:
        maxAttempts: 3
        waitDuration: 500ms
        enableExponentialBackoff: true
        exponentialBackoffMultiplier: 2
        retryExceptions:
          - org.springframework.web.client.HttpServerErrorException
          - org.springframework.web.client.ResourceAccessException
        ignoreExceptions:
          - io.github.resilience4j.circuitbreaker.CallNotPermittedException
Zwróć uwagę, że tutaj maxAttempts: 3 oznacza 3 wywołania łącznie z pierwszym, a nie jak w @Retryable ze Springa 3 ponowienia. Kolejność można też zmienić właściwościami typu resilience4j.retry.retryAspectOrder i resilience4j.circuitbreaker.circuitBreakerAspectOrder (wyższa wartość oznacza wyższy priorytet), ale w większości przypadków domyślna kolejność ma sens i nie ruszałbym jej bez powodu.
Jeszcze jedna rada z mojej strony: nie mieszaj na jednej metodzie @Retryable ze Springa z @Retry z Resilience4j. Oba mechanizmy działają przez proxy, każdy ma swoją kolejność i łatwo skończyć z retry w retry, czyli zamiast 4 wywołań robi się 12. Jeśli i tak dodajesz Resilience4j dla circuit breakera, to moim zdaniem prościej trzymać tam całą konfigurację, łącznie z retry.
Przy okazji: jeśli awaria zewnętrznej usługi nie dotyczy pojedynczego zapytania, tylko całego procesu biznesowego rozpisanego na kilka mikroserwisów, to retry i circuit breaker to za mało. Wtedy trzeba pomyśleć o tym, jak cofnąć to, co już się wykonało, i tutaj odsyłam Cię do wpisu o wzorcu SAGA i spójności danych w mikroserwisach.
Kiedy co wybrać
Całość w jednej tabeli, do której możesz wrócić przy następnej integracji:
Dla API, które zwykle działa i tylko czasem rzuci chwilowym błędem, timeouty w kliencie HTTP i @Retryable w zupełności wystarczą. Resilience4j dołożyłbym w momencie, gdy awaria tego API realnie blokuje coś ważnego (zamówienia, płatności, logowanie) i potrzebujesz circuit breakera z fallbackiem.
Podsumowanie
Zewnętrzne API prędzej czy później zawiedzie i lepiej mieć na to plan, zanim stanie się to na produkcji. Na start wystarczy to, co Spring Boot 4 daje bez dodatkowych zależności: timeouty w kliencie HTTP, @Retryable i @ConcurrencyLimit. Resilience4j dokładamy wtedy, gdy potrzebujemy circuit breakera, rate limitera albo fallbacku.
Dlatego przy następnej integracji zacznij od ustawienia timeoutów i zastanów się, co ma zobaczyć klient, gdy API kuriera (albo każde inne) przestanie odpowiadać. Sama technika to już wtedy kwestia kilku adnotacji i paru linijek w application.yml.
A Ty jak zabezpieczasz integracje z zewnętrznymi API w swoich projektach? Daj znać w komentarzu.


